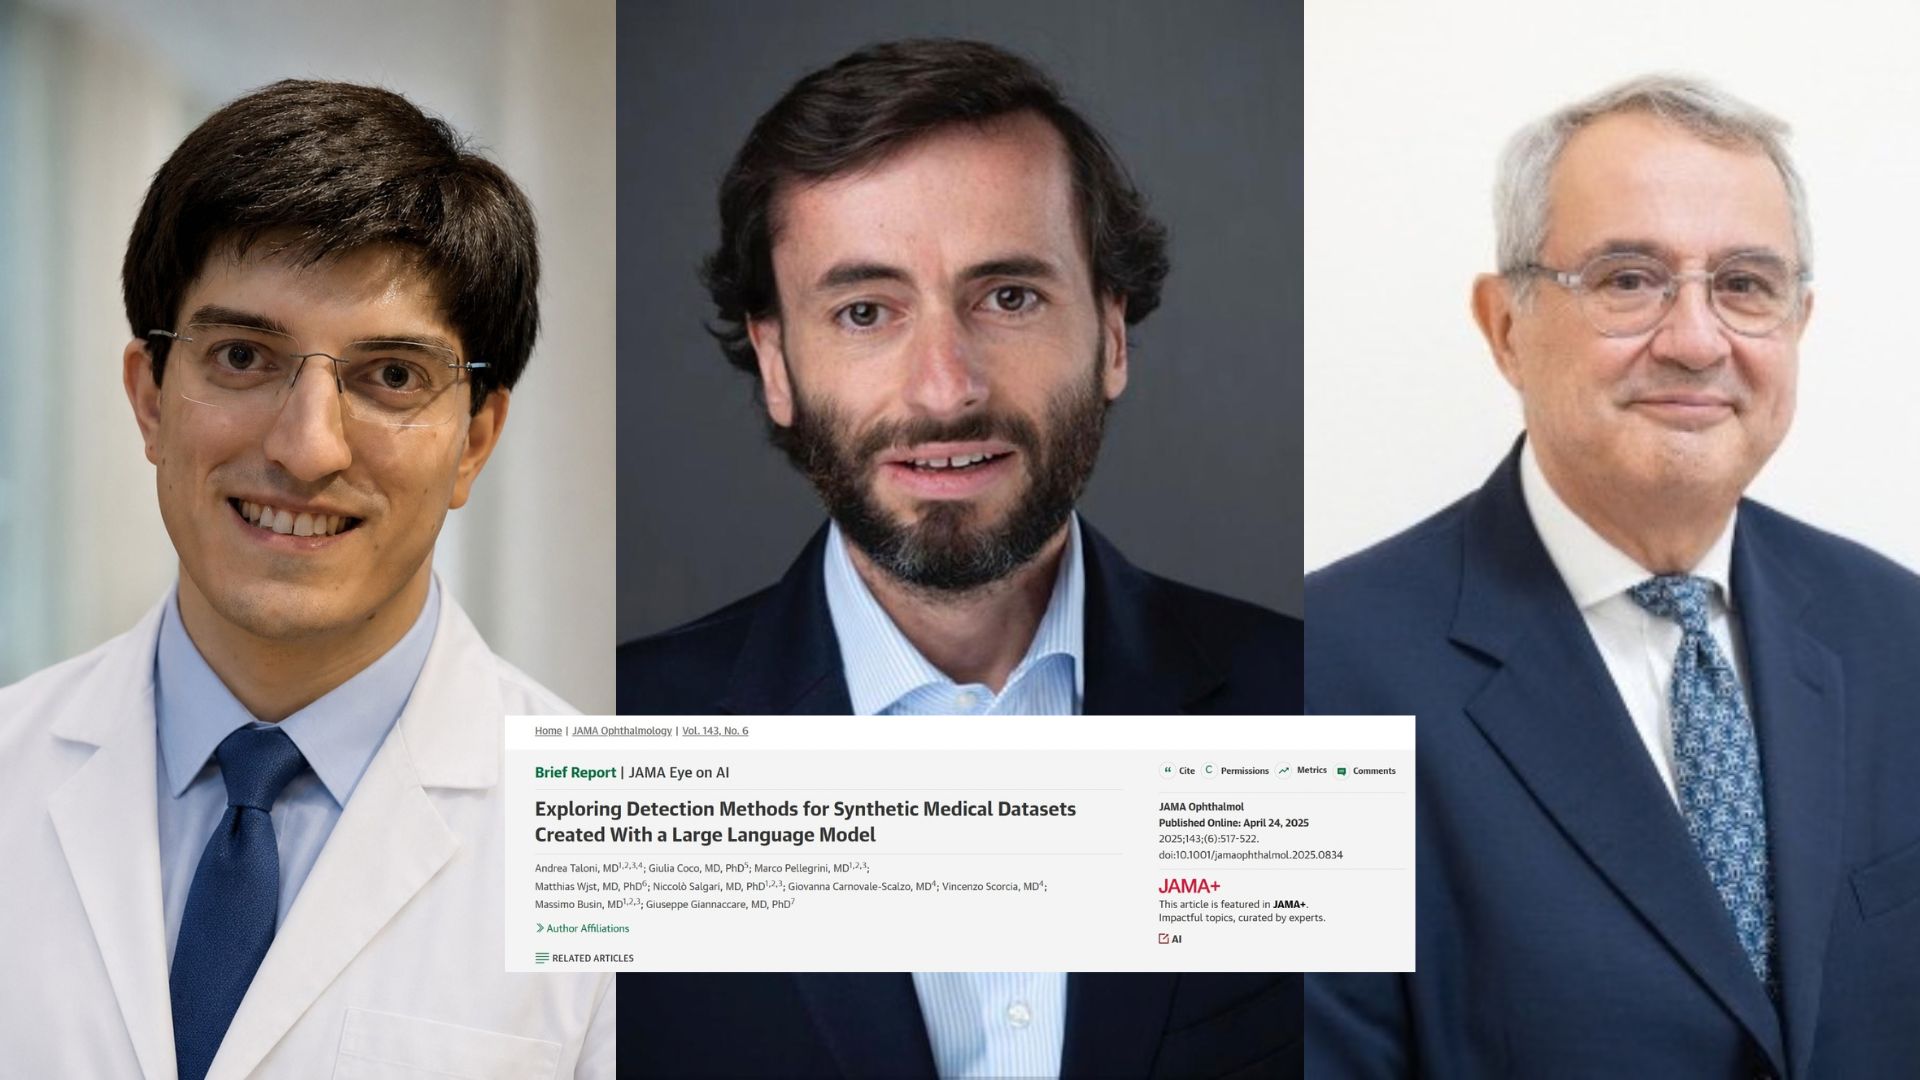
Pazienti con un nome e un cognome, una data di nascita, visite mediche, valori clinici, terapie ed esiti. Peccato che non siano mai esistiti. A crearli è stata l’intelligenza artificiale generativa (ChatGPT), istruita per costruire uno studio scientifico capace di arrivare alla conclusione richiesta in partenza.
È da qui che parte il lavoro di Andrea Taloni, Ricercatore di Malattie dell’Apparato Visivo dell’Università di Ferrara presso il Dipartimento di Medicina Traslazionale e per la Romagna, che ha attirato l’attenzione di Milena Gabanelli e Andrea Priante, i quali ne hanno presentato pochi giorni fa dati e implicazioni su Dataroom e Corriere della Sera. Un lavoro condotto insieme, tra gli altri, al Professor Massimo Busin, Ordinario dell’Università di Ferrara nello stesso Dipartimento, e al Professor Giuseppe Giannaccare, Ordinario dell’Università di Cagliari. Il loro studio del 2025 è stato pubblicato sulla prestigiosa rivista americana Jama Ophthalmology.
Tutto comincia quasi per curiosità, racconta Taloni. Quando i primi modelli generativi iniziano a mostrare capacità sempre più sofisticate, prova a chiedere all’AI di inventare un caso clinico di cheratocono (una malattia degenerativa della cornea). La risposta lo sorprende: non compare soltanto una descrizione plausibile, ma anche numeri, valori dell’astigmatismo e tutta quella serie di informazioni che normalmente finirebbero nella cartella di un paziente.
È allora che sorge una domanda: se può inventarne uno, perché non cento o mille?
“Mi sono chiesto se fosse possibile abusarne per creare finti studi clinici“, racconta. Nel primo esperimento il gruppo chiede all’AI di costruire i dati relativi a due diverse tecniche chirurgiche e, soprattutto, le impone in partenza che una debba risultare migliore dell’altra. L’AI esegue fedelmente. Nel 2023 quel primo lavoro viene pubblicato sempre su Jama Ophthalmology: la possibilità di fabbricare dal nulla un dataset medico non è più soltanto teorica.
Con il secondo studio del 2025 il problema si fa più serio. Il team crea database riferiti a tre ipotetici studi clinici in campo oftalmologico e li sottopone ad analisi forense. All’inizio l’inganno si vede. Ci sono pazienti con nomi incompatibili con il sesso indicato, date di visita improbabili, nascite concentrate stranamente solo in alcuni mesi. Anche i numeri tradiscono una certa artificialità: distribuzioni innaturali, cifre finali che tendono a ripetersi.
A quel punto i ricercatori fanno qualcosa di decisivo: spiegano all’intelligenza artificiale come era stata scoperta e le chiedono di correggere i difetti. Semplicemente con un prompt più preciso.
Funziona.
Nei database successivi molti degli errori spariscono e quattro dei dodici dataset “raffinati” superano i controlli forensi utilizzati nello studio come compatibili con dati autentici. È il 33,3%.
“È questo l’aspetto allarmante – dice Taloni -. Perché riconoscere la contraffazione non è sempre possibile”. E la tecnologia utilizzata nell’esperimento era quella disponibile nel 2024. “Oggi è maturata – osserva -. Continueremo a investigare l’argomento per capire quanto siano cambiate le cose“.
Nel frattempo, la barriera tecnica si è ulteriormente abbassata. Per costruire un database del genere, spiega, non servono necessariamente grandi competenze informatiche: “Basta creare un prompt opportuno“. E non è nemmeno necessario inventare tutto da zero. Si potrebbe partire da dati veri e modificarne soltanto una parte, quanto basta per rendere più convincente un’ipotesi. “La frode accademica è sempre esistita. Quello che cambia è la potenziale accessibilità a questo tipo di abuso“.
È qui che il problema smette di riguardare soltanto ChatGPT. Il processo di peer review, cioè il sistema con cui gli articoli vengono controllati da altri esperti prima della pubblicazione, quasi mai prevede che il revisore chieda e analizzi l’intero database originale. Farlo sistematicamente renderebbe il processo enormemente più pesante. Anche perché, ricorda Taloni, “il revisore non viene pagato per fare questo lavoro che necessita di molto tempo”.
E poi c’è il convitato di pietra dell’università contemporanea: pubblicare. “Il sistema accademico attuale incentiva a pubblicare il più possibile“, osserva Taloni. “Velocizzare il processo fino alla manipolazione dei dati può diventare vantaggioso per chi decide di comportarsi in questo modo”.
La soluzione, quindi, non può limitarsi a chiedere più controlli. Si potrebbe analizzare più spesso il dato grezzo, introdurre sistemi automatici di verifica o ricorrere a tecnologie di tracciamento e watermark. Ma non esiste, ammette Taloni, una risposta semplice. E soprattutto nessuno sa quanto il fenomeno sia già diffuso: “Non sappiamo se sia già stato fatto”. Esistono casi documentati di manipolazione di immagini e testi pubblicati su riviste prestigiose, persino sul New England Journal of Medicine, ma stabilire se qualcuno abbia già costruito o alterato interi dataset con questi strumenti è molto più difficile.
In un’era tecnologica in cui tutto è falsificabile, l’affidabilità e la credibilità scientifica del gruppo di ricerca unitamente alla qualità della rivista avranno sempre più peso nella valutazione di un prodotto.
Sarebbe facile, a questo punto, concludere che l’AI sia il nemico. Taloni fa esattamente il contrario. “Non va demonizzata questa tecnologia. Bisogna conoscerla e sfruttarla nella maniera giusta”.
In medicina, ricorda, sistemi di machine learning e deep learning sono già utilizzati da anni per aumentare l’accuratezza diagnostica. Il problema nasce quando lo strumento smette di affiancare la competenza umana e comincia a sostituirla.
Vale per il medico che accetta senza controllo l’indicazione di un algoritmo, ma anche per un paziente che chiede a un chatbot quale farmaco assumere: la risposta può essere corretta novantanove volte su cento. Resta quella centesima.
E persino il modo in cui formuliamo una domanda può orientare la risposta. “Dobbiamo verificare prudentemente l’operato di questi strumenti – ribadisce Taloni -. Se lo facciamo, l’AI può diventare un alleato potentissimo“. Se invece le deleghiamo anche il giudizio, ecco che il rischio è perdere proprio ciò che dovrebbe rimanere umano.
Per la medicina significa anche riscoprire qualcosa di molto poco tecnologico: “Noi medici dobbiamo valorizzare il nostro ruolo non soltanto come conoscitori della materia, ma nel rapporto con il paziente, che un’AI non può sostituire“.
Grazie per aver letto questo articolo...
Da 20 anni Estense.com offre una informazione indipendente ai suoi lettori e non ha mai accettato fondi pubblici per non pesare nemmeno un centesimo sulle spalle della collettività. Il lavoro che svolgiamo ha un costo economico non indifferente e la pubblicità dei privati non sempre è sufficiente.
Per questo chiediamo a chi quotidianamente ci legge e, speriamo, ci apprezza di darci un piccolo contributo in base alle proprie possibilità. Anche un piccolo sostegno, moltiplicato per le decine di migliaia di ferraresi che ci leggono ogni giorno, può diventare fondamentale.
OPPURE se preferisci non usare PayPal ma un normale bonifico bancario (anche periodico) puoi intestarlo a:
Scoop Media Edit
IBAN: IT06D0538713004000000035119 (Banca BPER)
Causale: Donazione per Estense.com